Комментарий #164258

Ответы

morr#
подробности
Берём матрицу, где одно изменение - пользователи, а другое - аниме

В ячейки заносим оценки. Соответственно взяв полностью любую колонку матрицы, мы получим "вектор характеристик пользователя". (Для аниме это будет вектор из шести тысяч элементов, где большая часть значений будет нулями, т.к. оценить пользователь может лишь малую часть базы).
Затем с помощью singular value decomposition
 youtube
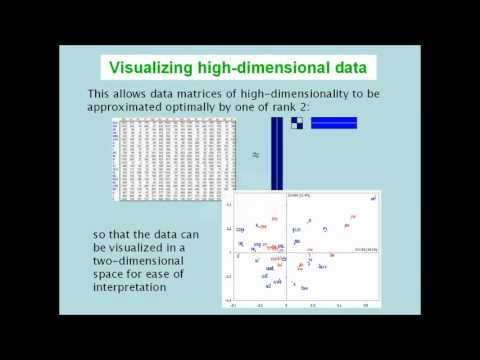
преобразуем матрицу в произведение трёх матриц, из которых нас будет интересовать только одна, третья V.transpose

Содержимое этой матрицы - векторы характеристик пользователя, схлопнутые с размера 6000 тысяч(по изменению на каждое аниме) до вектора двухмерном пространстве, где каждого пользователя характеризуют лишь две цифы, и эти цифры можно представить на двумерной плоскости в виде точек

Каждая красная точка - пользователь, а похожесть между пользователями - косинусное расстояние между точками
Первая матрица U тоже интересна, это двумерные векторы характеристик каждого аниме(схлопнутые из вектора размером в Users.count). На картинке выше они представленные в виде синих точек, между котороыми теперь тоже можно считать расстояние, тоесть находить похожие аниме не по прямому указанию пользователей как на MAL'е (и здесь соответственно), а автоматически.
Собственно реализация всего этого есть вот тут /recommendations/anime/svd/45
Вот только от похожести по пирсону с нормализаций оценок по z-score(всё из этой книги брал www.amazon.com ) оно не сильно отличается в итоге, а считается SVD ну очень уж сложно.
Если расчитывать SVD по всем пользователям и по всем аниме, то расчёт этих трёх матриц SVD занимает где-то 3-4 часа времени на i7 процессоре моего ноутбука(и это не код на медленному руби, цифры молотятся библиотекой, написанной на C)(хотя возможно где-то накосячил или библиотека кривая). Если матрицу сильно уменьшить, выкинув часть пользователей и большую часть аниме, то время расчёта может быть сокращено до уже не помню сколько, толи несколько минут, толи десяток-другой минут.
Особенность этих трёх матриц SVD ещё в том, что когда мы хотим предсказать оценки для произвольного пользователя, то нам не обязательно наличие этого самого пользователя в матрицах. Это как бы "психопаспорт всего сайта". Помножив вектор оценок пользователи на какие-то две из трёх матриц SVD, мы получим предсказание оценок данного пользователя. Этот момент я сам не очень понимаю, но он работает, эта страница /recommendations/anime/svd/45 тому доказательство.
Помимо долгого вычисления SVD тут ещё проблема в том, что не для каждого пользователя оно работает, есть какие-то граничные ситуации, в которых расчёт не применим, уже не помню какие, помню лишь, что что-то там с кем-то как-то иногда не считается. Из-за этого через заранее рассчитанные SVD матрицы мы не можем гарантированно вычислить похожесть пользователя A и пользователя B, увы.
А ещё т.к. SVD все равно, какие матрицы перелопачивать, в изначальную матрицу, где только оценки, можно добавлять произвользные характеристики вроде таких: любит миядзаки(1/0), любит сёдзе(1/0), любит что-то там ещё(1/0), каждой характеристике можем назначить определённый вес. А если ещё подумать, то эти дополнительные характеристики можно не в изначальную матрицу совать, а в уже в V.transpose, полученную через SVD. В общем вариантов тут целое море можно придумать.
Вот только я убил на всё это (вникнуть как работает и реализовать) кучу свободного времени выходных майских праздников, а получил результат ненмного лучше простого pearson z-score, а скорее даже несколько хуже. Да, базовый SVD гораздо лучше того, что было раньше, но после апгрейда основного алгоритима, выгоды не вижу. А чтобы SVD стал лучше (а он обязательно будет луше дефолтного обычной коллаборативной фильтрации) надо потратить ещё N недель времени, что я сделать пока больше не готов. Поэтому в планах оставить как есть, занявшись другими вещами, а после ещё попробовать добавить жанровый коэффициент как предложил змей в своём pdf файле.

В ячейки заносим оценки. Соответственно взяв полностью любую колонку матрицы, мы получим "вектор характеристик пользователя". (Для аниме это будет вектор из шести тысяч элементов, где большая часть значений будет нулями, т.к. оценить пользователь может лишь малую часть базы).
Затем с помощью singular value decomposition
 youtube
преобразуем матрицу в произведение трёх матриц, из которых нас будет интересовать только одна, третья V.transpose

Содержимое этой матрицы - векторы характеристик пользователя, схлопнутые с размера 6000 тысяч(по изменению на каждое аниме) до вектора двухмерном пространстве, где каждого пользователя характеризуют лишь две цифы, и эти цифры можно представить на двумерной плоскости в виде точек

Каждая красная точка - пользователь, а похожесть между пользователями - косинусное расстояние между точками
Первая матрица U тоже интересна, это двумерные векторы характеристик каждого аниме(схлопнутые из вектора размером в Users.count). На картинке выше они представленные в виде синих точек, между котороыми теперь тоже можно считать расстояние, тоесть находить похожие аниме не по прямому указанию пользователей как на MAL'е (и здесь соответственно), а автоматически.
Собственно реализация всего этого есть вот тут /recommendations/anime/svd/45
Вот только от похожести по пирсону с нормализаций оценок по z-score(всё из этой книги брал www.amazon.com ) оно не сильно отличается в итоге, а считается SVD ну очень уж сложно.
Если расчитывать SVD по всем пользователям и по всем аниме, то расчёт этих трёх матриц SVD занимает где-то 3-4 часа времени на i7 процессоре моего ноутбука(и это не код на медленному руби, цифры молотятся библиотекой, написанной на C)(хотя возможно где-то накосячил или библиотека кривая). Если матрицу сильно уменьшить, выкинув часть пользователей и большую часть аниме, то время расчёта может быть сокращено до уже не помню сколько, толи несколько минут, толи десяток-другой минут.
Особенность этих трёх матриц SVD ещё в том, что когда мы хотим предсказать оценки для произвольного пользователя, то нам не обязательно наличие этого самого пользователя в матрицах. Это как бы "психопаспорт всего сайта". Помножив вектор оценок пользователи на какие-то две из трёх матриц SVD, мы получим предсказание оценок данного пользователя. Этот момент я сам не очень понимаю, но он работает, эта страница /recommendations/anime/svd/45 тому доказательство.
Помимо долгого вычисления SVD тут ещё проблема в том, что не для каждого пользователя оно работает, есть какие-то граничные ситуации, в которых расчёт не применим, уже не помню какие, помню лишь, что что-то там с кем-то как-то иногда не считается. Из-за этого через заранее рассчитанные SVD матрицы мы не можем гарантированно вычислить похожесть пользователя A и пользователя B, увы.
А ещё т.к. SVD все равно, какие матрицы перелопачивать, в изначальную матрицу, где только оценки, можно добавлять произвользные характеристики вроде таких: любит миядзаки(1/0), любит сёдзе(1/0), любит что-то там ещё(1/0), каждой характеристике можем назначить определённый вес. А если ещё подумать, то эти дополнительные характеристики можно не в изначальную матрицу совать, а в уже в V.transpose, полученную через SVD. В общем вариантов тут целое море можно придумать.
Вот только я убил на всё это (вникнуть как работает и реализовать) кучу свободного времени выходных майских праздников, а получил результат ненмного лучше простого pearson z-score, а скорее даже несколько хуже. Да, базовый SVD гораздо лучше того, что было раньше, но после апгрейда основного алгоритима, выгоды не вижу. А чтобы SVD стал лучше (а он обязательно будет луше дефолтного обычной коллаборативной фильтрации) надо потратить ещё N недель времени, что я сделать пока больше не готов. Поэтому в планах оставить как есть, занявшись другими вещами, а после ещё попробовать добавить жанровый коэффициент как предложил змей в своём pdf файле.
Похожесть пользователей считается сейчас по старому, но её ещё переделаю, может быть даже на днях. Выдавать они будет совсем другие цифры, чем сейчас.
P.S. Выше там много чего написано по другим темам. Я обязательно прочитаю и отвечу. Позже.
Твой комментарий
@morr